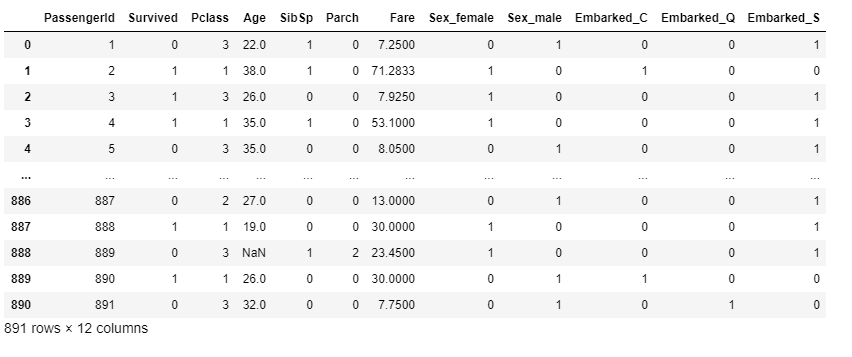
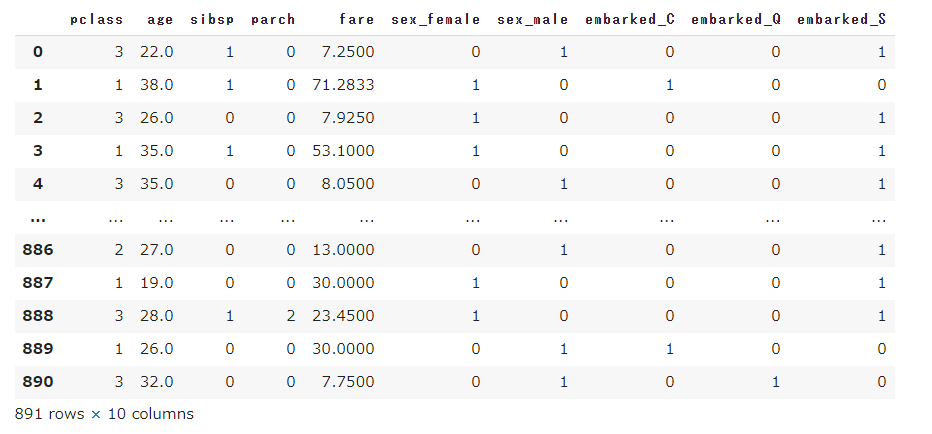
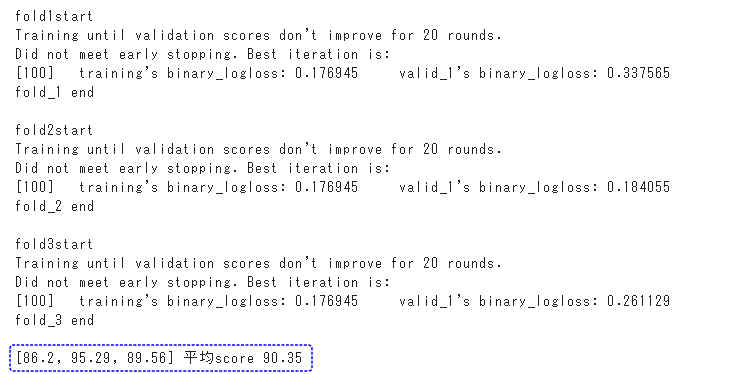
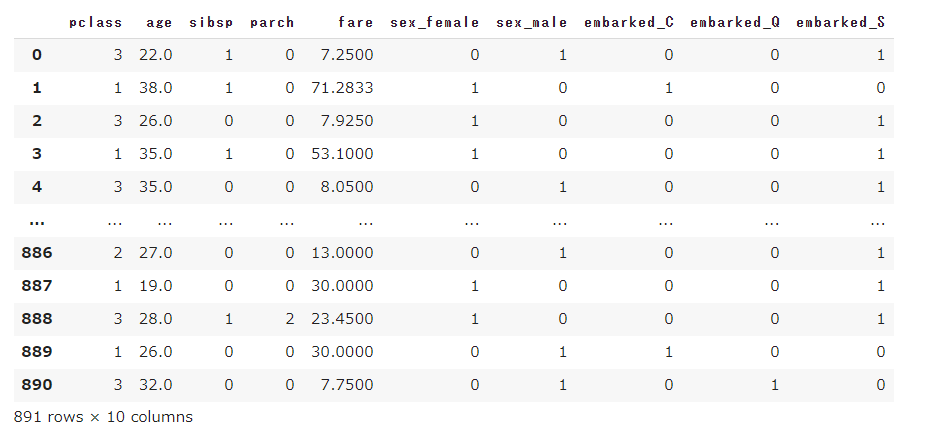
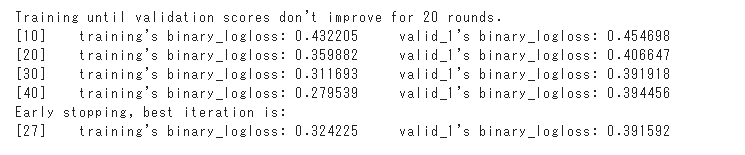
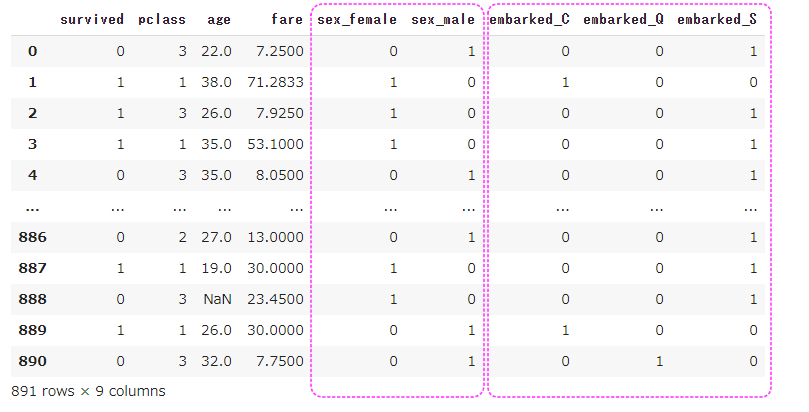
これまでデータの前処理を行うときに、カテゴリー変数についてはOne-Hotエンコーディングを行っていました。
しかし【LightGBMのドキュメント】によると、カテゴリー変数はOne-Hotエンコーディングするよりも0から始まる連続した整数に変換するほうが優れたパフォーマンスを発揮するとのことでした。
今回はOne-Hotエンコーディングの代わりに、カテゴリー変数を整数に変換してタイタニック・コンペに提出してみます。
データ読み込みと前処理
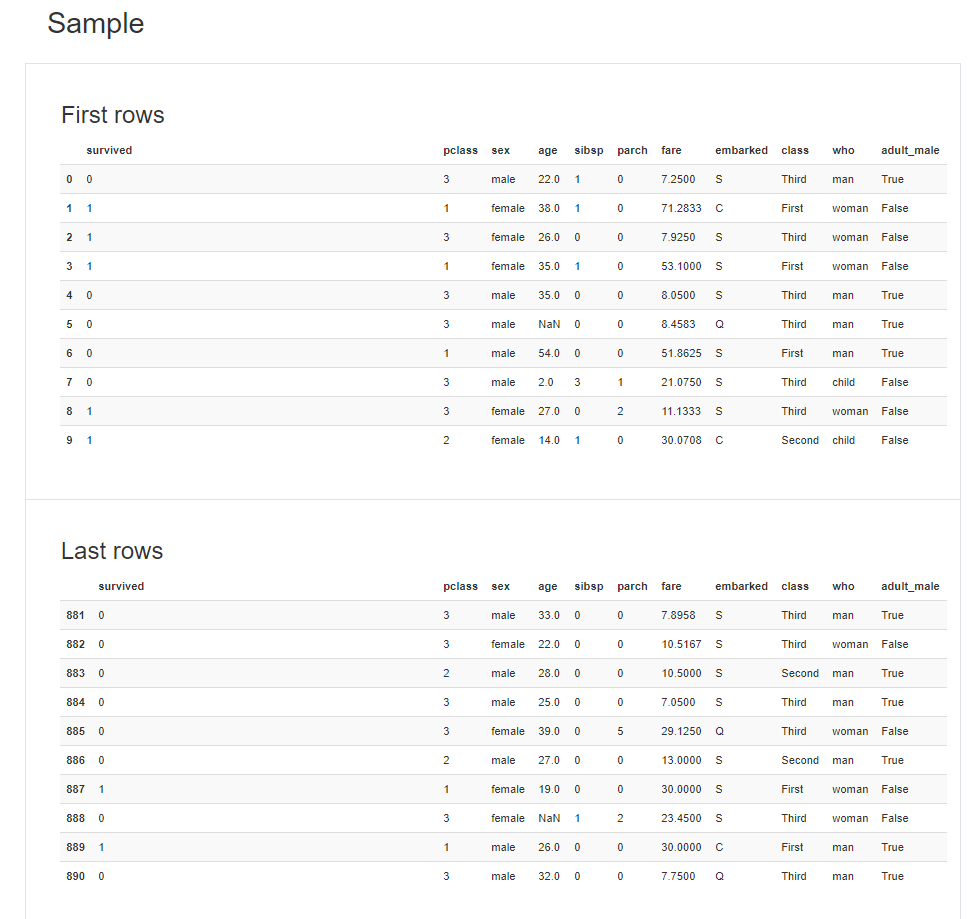
まずはいつも通りタイタニックのデータセットを読み込みます。
[ソース]
1 | import numpy as np |
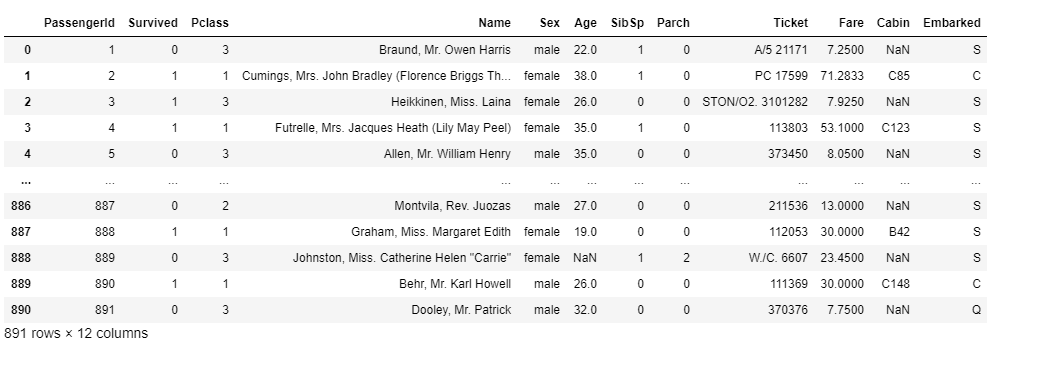
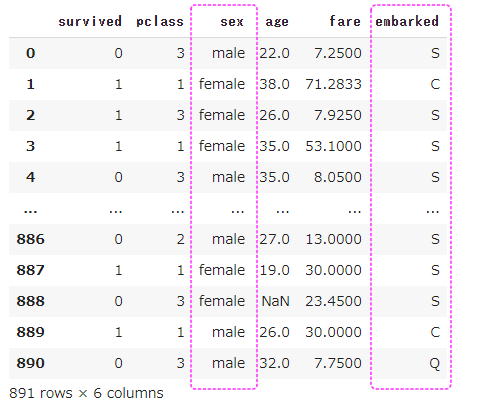
今回のポイントであるデータ前処理ですが、LightGBMで学習・推測するためには下記の5変数を変換する必要があります。
- Name
- Sex
- Ticket
- Cabin
- Embarked
このうち生存率に関係のなさそうなNameとTicketとCabinは単純に削除します。
そしてSexとEmbarkedを整数に変換したいのですが、一番カンタンそうな方法はデータ型をcategory型に変えることでした。
こうすることによって、自動でカテゴリーを変換した整数として扱ってくれるので、自分で0や1などの整数に置き換える必要がなくとてもラクチンでした。
[ソース]
1 | # データ前処理 |
データの前処理が終わりましたら、以前実行した時と同じようにLightGBMを使って学習を行います。
[ソース]
1 | import lightgbm as lgb |
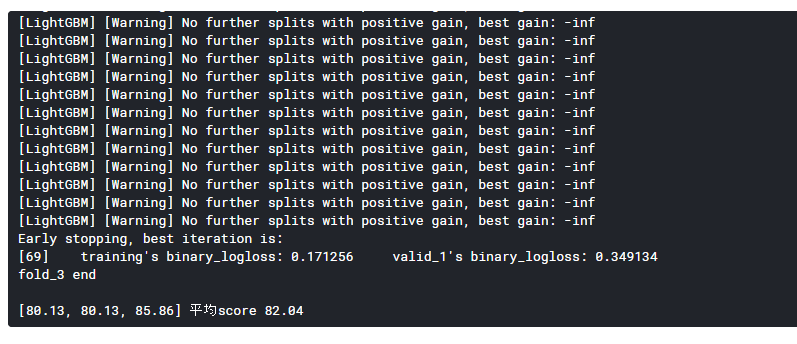
[出力]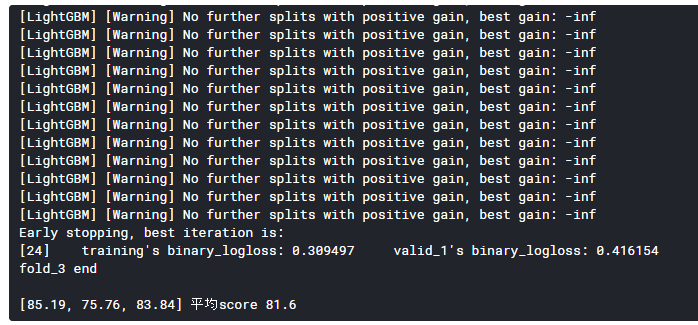
平均正解率は81.6%とそこそこの結果というところでしょうか。
最後に、学習したモデルを使って、生存の推測を行い提出用のCSVファイルを出力します。
検証データに対してもデータの前処理(3行目)を行うことをお忘れなく。
[ソース]
1 | # 検証データの読み込み |
予測結果を提出します。
[提出結果]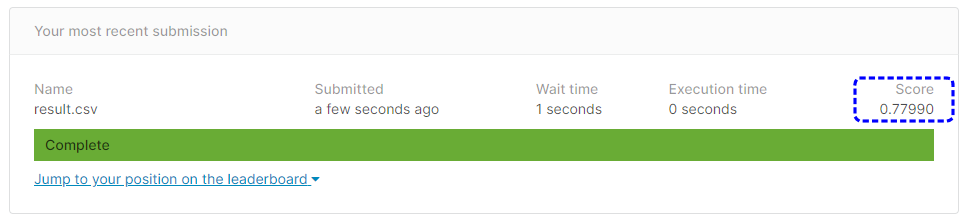
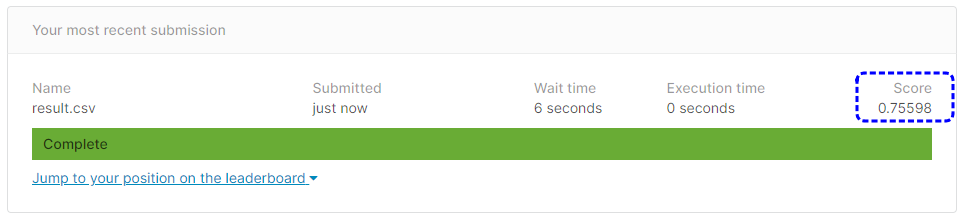
提出結果は77.99%という正解率になりました。
カテゴリ変数をOne-Hotエンコーディングしときの結果は75.59%でしたので2.4%ほど正解率が上がりました。