シュレーディンガー方程式

シュレーディンガー方程式

シュレーディンガー方程式は量子力学における基本的な方程式の一つであり、粒子の波動関数の時間変化を記述します。

しかし、シュレーディンガー方程式を正確に解くことは通常、解析的には不可能であるため、数値的な近似解を求めることが一般的です。

以下に、一次元の無限井戸ポテンシャル下でのシュレーディンガー方程式の時間依存性を無視した定常状態の解を求めるPythonのコードを示します。

このコードは、一次元の無限井戸の中を動く粒子の波動関数を計算し、それをプロットします。

無限井戸は物理学における理想化されたモデルで、井戸の中を動く粒子は井戸の壁を超えて脱出することはありません。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
import numpy as np
import matplotlib.pyplot as plt
from scipy.sparse import diags
from scipy.sparse.linalg import eigs

# 定数
N = 1000 # 格子点の数
mass = 1.0 # 粒子の質量
hbar = 1.0 # 換算プランク定数
L = 1.0 # 井戸の幅
x = np.linspace(0, L, N) # 位置

# 差分化
dx = x[1] - x[0]
T = hbar**2 / (2.0 * mass * dx**2) * (diags([1, -2, 1], [-1, 0, 1], shape=(N, N)).toarray())

# エネルギー固有値と波動関数の計算
values, vecs = eigs(T, k=30, which='SM')
idx = values.real.argsort()
values = values.real[idx]
vecs = vecs.real[:, idx]

# 波動関数の正規化とプロット
for n in range(3): # 最初の3つのエネルギー状態をプロット
psi = vecs[:, n] / np.sqrt(dx)
plt.plot(x, psi, label='E = %.2f' % values[n])

plt.title('Wavefunctions in a 1D Infinite Square Well')
plt.xlabel('x')
plt.ylabel('psi')
plt.legend(loc='upper right')
plt.grid(True)

plt.show()

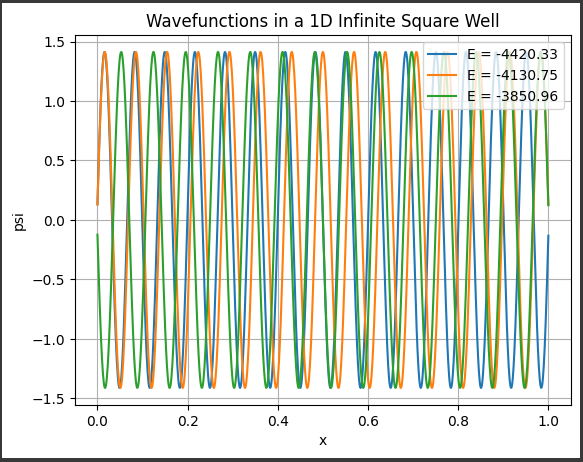
このコードでは最初の3つのエネルギー状態の波動関数をプロットします。

エネルギーが増えるにつれて波のノード(波の振幅がゼロとなる点)の数が増えることが確認できます。

これは量子力学における特從性の一つであり、粒子のエネルギー状態を視覚化することができます。

[実行結果]
ソースコード解説

このコードは、1次元の無限長方形井戸内の粒子の波動関数を計算し、その結果をグラフ化するものです。

1. ライブラリのインポート

1
2
3
4
import numpy as np
import matplotlib.pyplot as plt
from scipy.sparse import diags
from scipy.sparse.linalg import eigs
  • numpyは数値計算のためのライブラリで、配列操作や数学関数を提供します。
  • matplotlib.pyplotはグラフ描画のためのライブラリで、グラフの作成やカスタマイズを行います。
  • scipy.sparse.diagsは疎行列を扱うためのライブラリで、特定のパターンの疎行列を生成します。
  • scipy.sparse.linalg.eigsは疎行列の固有値問題を解くためのライブラリで、固有値と固有ベクトルを計算します。

2. 定数の設定

1
2
3
4
5
N = 1000  # 格子点の数
mass = 1.0 # 粒子の質量
hbar = 1.0 # 換算プランク定数
L = 1.0 # 井戸の幅
x = np.linspace(0, L, N) # 位置
  • Nは格子点の数、massは粒子の質量、hbarは換算プランク定数、Lは井戸の幅を表します。
  • np.linspaceは$0$から L までの範囲を N 分割した値の配列を生成します。
    これにより、位置 x の配列が作成されます。

3. 差分化

1
2
dx = x[1] - x[0]
T = hbar**2 / (2.0 * mass * dx**2) * (diags([1, -2, 1], [-1, 0, 1], shape=(N, N)).toarray())
  • dxは隣接する位置の差を表します。
  • diags関数は特定のパターンの疎行列を生成します。
    ここでは、2階微分の差分演算子を表す疎行列$ (T) $を生成しています。

4. エネルギー固有値と波動関数の計算

1
2
3
4
values, vecs = eigs(T, k=30, which='SM')
idx = values.real.argsort()
values = values.real[idx]
vecs = vecs.real[:, idx]
  • eigs関数を使用して疎行列$ (T) $の固有値と対応する固有ベクトル(波動関数)を計算します。
  • k=30は最初の$30個$の固有値と固有ベクトルを取得することを意味します。
  • which='SM'は最小の固有値から計算を行うことを指定します。

5. 波動関数の正規化とプロット

1
2
3
4
5
6
7
8
9
10
11
for n in range(3):  # 最初の3つのエネルギー状態をプロット
psi = vecs[:, n] / np.sqrt(dx)
plt.plot(x, psi, label='E = %.2f' % values[n])

plt.title('Wavefunctions in a 1D Infinite Square Well')
plt.xlabel('x')
plt.ylabel('psi')
plt.legend(loc='upper right')
plt.grid(True)

plt.show()
  • 取得した固有ベクトル(波動関数)を正規化し、最初の3つのエネルギー状態に対応する波動関数をグラフ化しています。
  • plt.plotで各波動関数を位置$ (x) $に対する波動関数の値$ (\psi) $としてプロットしています。
  • plt.title、plt.xlabel、plt.ylabelはそれぞれグラフのタイトルと軸ラベルを設定し、plt.legendで凡例を表示しています。
  • plt.grid(True)はグリッド線を表示し、plt.show()でグラフを表示しています。

グラフ解説

[実行結果]

このグラフは、1次元の無限長方形井戸内の粒子の波動関数を計算し、その結果を表示したものです。

まず、N個の格子点で井戸の幅が L である領域を考えています。
その後、この領域を離散化するために、差分化を行っています。
具体的には、2階微分を表す行列$ (T) $を作成しています。
この行列は、離散的な位置$ (x)$ における運動エネルギーの演算子(運動量の二乗に比例する部分)を表します。

次に、eigs関数を使用して$ (T) $の固有値と対応する固有ベクトル(波動関数)を計算しています。
ここで k=30 は、最初の$30$個の固有値と固有ベクトルを取得することを意味します。
そして which='SM' は、最小の固有値から計算を行うことを指定しています。

最後に、最初の3つのエネルギー状態に対応する波動関数を取り出し、それぞれを正規化してグラフ化しています。
波動関数は各エネルギー状態における粒子の振る舞いを示し、横軸が位置$ (x) $、縦軸が波動関数$ (\psi) $の値を表しています。

タイトルは「Wavefunctions in a 1D Infinite Square Well」であり、各波動関数のラベルには対応するエネルギー値 $ (E) $が表示されており、それぞれのエネルギー状態が異なるラインで示されています。
ポートフォリオ最適化問題

ポートフォリオ最適化問題

ポートフォリオ最適化問題の例を、3つの資産(ビットコイン、イーサリアム、米ドル)で考え、3Dグラフ化します。

以下のPythonコードでは、それぞれの資産への投資比率を調整し、ポートフォリオのリターンを最大化するように最適化します。

各投資比率は$0$から$1$の間の値をとり、全体の和は$1$となる制約があります。

必要となるライブラリをインストールします。

1
!pip install cvxpy matplotlib numpy

それでは、3Dでのグラフ化を含む以下のコードをご覧ください。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
import cvxpy as cp
import numpy as np
import matplotlib.pyplot as plt
from mpl_toolkits.mplot3d import Axes3D

# ビットコイン、イーサリアム、米ドルのリターン
r_btc = 7.0
r_eth = 5.0
r_usd = 2.0

# 投資比率の変数 (0 ≦ x, y ≦ 1)
x = cp.Variable() # ビットコインへの投資比率
y = cp.Variable() # イーサリアムへの投資比率

# 目的関数 - ポートフォリオリターンの最大化
objective = cp.Maximize(r_btc * x + r_eth * y + r_usd * (1 - x - y))

# 制約条件
constraints = [x >= 0, y >= 0, x + y <= 1]

# 最適化問題の定義
prob = cp.Problem(objective, constraints)

# 3Dグラフ描画のための範囲とグリッドを作成
btc_range = np.linspace(0, 1, 100)
eth_range = np.linspace(0, 1, 100)
b, e = np.meshgrid(btc_range, eth_range)
usd_range = 1 - b - e

# 最適化問題を解く
result = prob.solve()

print("最大ポートフォリオリターン: ", result)
print("最適なビットコインへの投資比率: ", x.value)
print("最適なイーサリアムへの投資比率: ", y.value)
print("最適な米ドルへの投資比率: ", 1 - x.value - y.value)

# 3Dプロットの作成
fig = plt.figure()
ax = fig.add_subplot(111, projection='3d')

# ポートフォリオのリターンをZ軸としてプロット
Z = r_btc * b + r_eth * e + r_usd * usd_range
mask = np.where(usd_range < 0, np.nan, Z)

ax.plot_surface(b, e, mask, rstride=1, cstride=1, color='b', alpha=0.2, zorder=-1)

# 最大化問題の点をプロット
ax.scatter(x.value, y.value, result, color="r", s=100)

ax.set_xlabel('Bitcoin')
ax.set_ylabel('Ethereum')
ax.set_zlabel('Return')

plt.show()

ちなみになりますが、多資産のポートフォリオ最適化は非常に複雑であり、多くの場合、相関関係、リスク等の他の要因を考慮する必要があります。

上記のコードは理論上の模範であり、実際の投資判断には利用しないでください。

[実行結果]

ソースコード解説

このPythonスクリプトは、cvxpyを使用して投資ポートフォリオの最適化問題を解き、3Dグラフを作成しています。

1. モジュールのインポート:

cvxpy、numpy、matplotlibの必要なモジュールをインポートしています。
cvxpyは最適化問題を解くためのライブラリです。

2. リターンの設定:

ビットコイン、イーサリアム、米ドルのリターンをそれぞれ変数r_btc、r_eth、r_usdに設定しています。

3. 変数の定義:

投資比率を示す変数x(ビットコインへの投資比率)とy(イーサリアムへの投資比率)をcvxpyの変数として定義しています。

4. 目的関数と制約条件の定義:

最大化したいポートフォリオリターンを目的関数として定義し、投資比率が$0$以上で、合計が$1$以下であるという制約条件を設定しています。

5. 最適化問題の定義と解決:

cvxpyを使用して最適化問題を定義し、.solve()メソッドを使って問題を解いています。

6. 最適化結果の出力:

解をresultに格納し、最適な投資比率を表示しています。

7. 3Dプロットの作成:

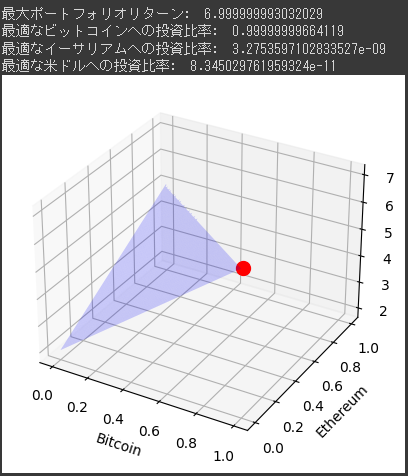
ビットコインとイーサリアムへの投資比率をX軸とY軸に、ポートフォリオのリターンをZ軸にした3Dグラフを作成しています。
赤い点は最大化されたポートフォリオの点を示しています。

このコードは、ビットコインとイーサリアムの投資比率を最適化し、ポートフォリオのリターンを視覚化しています。

結果解説

[実行結果]

この3Dグラフは、ビットコイン、イーサリアム、米ドルという3つの異なる資産に対する投資比率(X軸はビットコイン、Y軸はイーサリアム)と、それらの投資比率から導かれるポートフォリオのリターン(Z軸)の関係を示しています。

頂上の赤い点は、投資比率を最適化することによって達成可能な最大ポートフォリオリターンを示しています。

これは、ビットコイン、イーサリアム、米ドルへの最適な投資比率を用いた場合のリターンです。

このグラフを見ると、一部の領域が存在しないことに気づくかもしれません。

これは、ビットコイン、イーサリアム、米ドルへの投資比率の合計が100%を超えることはできないためです。

これら3つの資産への投資合計が1(または100%)を超える投資比率の組み合わせは不可能であり、そのためグラフから除外されています。

この3Dグラフはあくまで理論的なもので、実際の市場環境や投資戦略、リスク許容度によって最適なポートフォリオは変動します。

だからと言って、このグラフが無意味であるわけではありません。

次元の異なる複数の資産を持つポートフォリオのリターンを視覚化する一助となり、リスクとリターンのトレードオフを理解する上で有用なツールです。

最適化問題(3Dグラフ) CVXPY

最適化問題(3Dグラフ)

以下は、Pythonで3Dグラフを用いて最適化問題を解いて可視化する例です。

この例では、CVXPYを使用して、変数 $x$, $y$ の2つを持つ最適化問題を解きます。

目的関数は$ x^2 + y^2 $で、制約条件は$ x + y <= 1 $です。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
import cvxpy as cp
import numpy as np
import matplotlib.pyplot as plt
from mpl_toolkits.mplot3d import Axes3D

# 変数の定義
x = cp.Variable()
y = cp.Variable()

# 目的関数の定義
objective = cp.Minimize(x**2 + y**2)

# 制約条件の定義
constraints = [x + y <= 1]

# 最適化問題の定義
prob = cp.Problem(objective, constraints)

# 最適化問題の解決
result = prob.solve()

# 解を出力
print("Optimal value:", result)
print("Optimal x:", x.value)
print("Optimal y:", y.value)

# 3Dプロット
fig = plt.figure()
ax = fig.add_subplot(111, projection='3d')

x_vals = np.linspace(-1, 1, 100)
y_vals = np.linspace(-1, 1, 100)
x_mesh, y_mesh = np.meshgrid(x_vals, y_vals)
z = x_mesh**2 + y_mesh**2

ax.plot_surface(x_mesh, y_mesh, z, cmap='viridis', alpha=0.8)
ax.set_xlabel('X')
ax.set_ylabel('Y')
ax.set_zlabel('Objective function')

# 最適解をプロット
opt_x = x.value
opt_y = y.value
opt_z = opt_x**2 + opt_y**2
ax.scatter(opt_x, opt_y, opt_z, color='red', s=100, label='Optimal point')

plt.title('Optimization with CVXPY and 3D Plotting')
plt.legend()
plt.show()

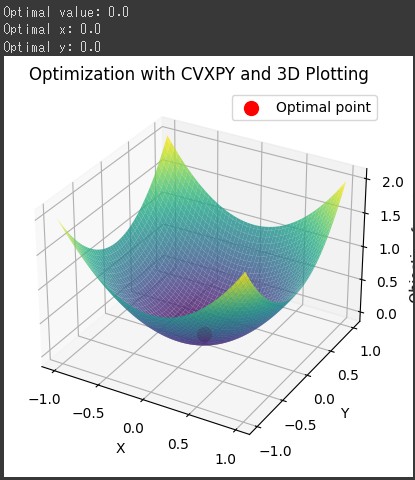
このコードでは、$x$と$y$の値を変化させた際の2変数関数$ x^2 + y^2 $を3Dプロットし、最適化された点を赤い点で示しています。

[実行結果]

ソースコード解説

このコードは、CVXPYを使用して最適化問題を解き、その結果を3Dプロットで可視化するものです。

以下はソースコードの詳細な説明です。

ライブラリのインポート

  • cvxpy as cp: CVXPYをcpとしてインポートします。
  • numpy as np: NumPyをnpとしてインポートします。
  • matplotlib.pyplot as plt: Matplotlibのpyplotモジュールをpltとしてインポートします。
  • mpl_toolkits.mplot3d: Matplotlibの3Dプロットを利用するためのモジュールです。

変数の定義

  • xとyはCVXPYの変数として定義されます。
    これらの変数は最適化問題の変数として使用されます。

目的関数の定義

  • objectiveは、最小化する目的関数を表しています。
    ここでは、$ (x^2 + y^2) $を最小化するように設定されています。

制約条件の定義

  • constraintsは、制約条件のリストです。
    この場合、$ (x + y \leq 1) $という制約条件が定義されています。

最適化問題の定義

  • probは、最適化問題を表します。
    objectiveとconstraintsを引数として渡して最適化問題を定義します。

最適化問題の解決

  • prob.solve()は、定義した最適化問題を解きます。
    最適な変数の値を見つけ、最小値を求めます。

解の出力

  • 求めた最適な変数の値と最適値を表示します。

3Dプロット

  • plt.figure(): 新しい図を作成します。
  • fig.add_subplot(111, projection='3d'): 3Dのサブプロットを追加します。
  • x_valsとy_valsは、それぞれ$-1$から$1$までの$100個$の等間隔の値を持つ配列です。
    これを使ってメッシュグリッドを生成します。
  • x_meshとy_meshはx_valsとy_valsを使って作成された格子状のデータです。
    それらに基づいて目的関数の値zを計算します。
  • ax.plot_surface(): メッシュグリッドを使用して3Dの曲面をプロットします。
    cmapはカラーマップ、alphaは透明度を指定します。
  • ax.set_xlabel()、ax.set_ylabel()、ax.set_zlabel(): 各軸のラベルを設定します。

最適解のプロット

  • ax.scatter(): 最適解を赤い点でプロットします。
    これは、最適解の$ (x) $と$ (y) $の値に対応する目的関数の値を表します。

グラフの表示

  • plt.title(): グラフのタイトルを設定します。
  • plt.legend(): 凡例を追加します。
  • plt.show(): グラフを表示します。

結果解説

[実行結果]

このコードは、CVXPYを使用して2変数の最適化問題を解き、その結果を3Dグラフで可視化しています。

最適化問題は、目的関数 $ (x^2 + y^2) $を最小化するというもので、制約条件は$ (x + y \leq 1) $です。
これは、2変数$ (x) $と$ (y) $の値を持つ平面上で$ (x^2 + y^2) $を最小化する問題です。

プログラムでは、変数$ (x) $と$ (y) $を定義し、目的関数および制約条件を設定しました。
その後、CVXPYを使って最適化問題を解決し、最適解の$ (x) $と$ (y) $の値を得ています。

3Dグラフでは、平面上の$ (x) $と$ (y) $の値を範囲指定してメッシュグリッドを生成し、それに対応する$ (x^2 + y^2) $の値を計算してプロットしています。
これにより、2変数関数$ (x^2 + y^2) $の3D表面が描かれます。

最適解は、求めた$ (x) $と$ (y) $の値を赤い点で表現しています。
これは、目的関数を最小化する最適な $ (x) $と$ (y) $の値を示しています。

つまり、このグラフは、2変数関数を3Dで可視化し、最適解を視覚的に示しています。

ベッセル関数

ベッセル関数

ベッセル関数は物理や数学で幅広く利用される特殊関数の一つです。

ベッセル関数の数式として、第一種ベッセル関数 $ ( J_n(x) ) $の例を示します:

$$
J_n(x) = \frac{1}{\pi} \int_{0}^{\pi} \cos(n\theta - x \sin \theta) , d\theta
$$

このベッセル関数をPythonでグラフ化するために、SciPyライブラリのベッセル関数を利用します。

以下がコードになります:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
import numpy as np
import matplotlib.pyplot as plt
from scipy.special import jn

x = np.linspace(0, 20, 1000) # xの範囲を設定

# 第一種ベッセル関数の計算(n=0, 1, 2)
for n in range(3):
y = jn(n, x) # ベッセル関数の計算
plt.plot(x, y, label=f'J{n}(x)') # グラフのプロット

plt.title('Bessel Functions')
plt.xlabel('x')
plt.ylabel('Jn(x)')
plt.legend()
plt.grid(True)
plt.show()

このコードでは、scipy.special.jn を使用してベッセル関数を計算し、それをMatplotlibを使ってグラフ化しています。

[実行結果]

ソースコード解説

このコードは、Pythonでベッセル関数(Bessel Functions)を計算し、Matplotlibを使用してグラフ化するものです。

1. NumPyとMatplotlibのインポート:

  • numpy を np としてインポートし、行列計算や数値演算を行うための機能を利用します。
  • matplotlib.pyplot を plt としてインポートし、グラフ描画のための機能を利用します。

2. SciPyからベッセル関数のインポート:

  • scipy.special モジュールから jn 関数をインポートしています。
    これはベッセル関数を計算するための関数です。

3. データの準備:

  • np.linspace(0, 20, 1000) によって、$0$から$20$の範囲を等間隔に$1000$点取得し、x に格納します。

4. ベッセル関数の計算とプロット:

  • for ループで range(3) を使用し、n が0から2まで変化します。
  • jn(n, x) を使って、x に対する第一種ベッセル関数(n=0, 1, 2)を計算します。
  • plt.plot(x, y, label=f'J{n}(x)') により、各 n のベッセル関数をプロットします。label を使って凡例を設定しています。

5. グラフの装飾:

  • plt.title、plt.xlabel、plt.ylabel を使って、タイトルや軸ラベルを設定します。
  • plt.legend() で凡例を表示します。
  • plt.grid(True) でグリッドを表示します。

6. グラフの表示:

  • plt.show() により、グラフを表示します。

このコードは、ベッセル関数を計算し、それをグラフ化しています。

それぞれのベッセル関数の振る舞いを可視化し、それが x の値に対してどのように変化するかを示しています。

グラフ解説

[実行結果]

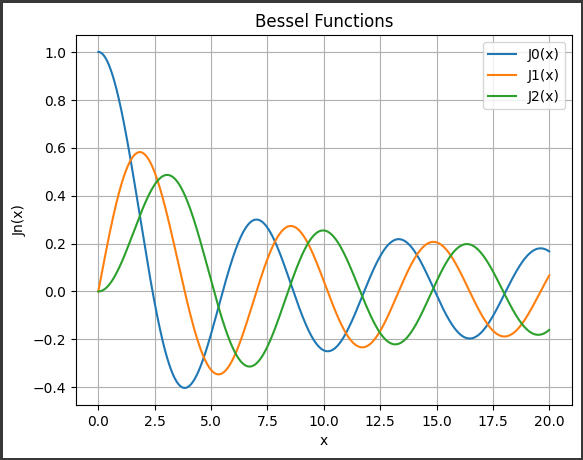
このグラフは、第一種ベッセル関数(Bessel Function of the First Kind)の値を示しています。
第一種ベッセル関数は微分方程式理論や物理学、工学など幅広い分野で重要な役割を果たす特殊関数です。

解析的な式で表されるこの関数は、x(横軸)と Jn(x)(縦軸)の関係を示しており、このグラフでは n=0、n=1、n=2 の3つのベッセル関数が描かれています。

  • n=0のベッセル関数(青の線)は、xが$0$のときに$1$に近づき、その後減少していきます
    xが大きくなるにつれて振動が小さくなり、$0$に収束します。
  • n=1のベッセル関数(オレンジの線)は、xが$0$のときに$0$になり、xが増加するにつれて振動して$±1$の間を移動します。
  • n=2のベッセル関数(緑の線)は、xが0のときに$0$になり、xが増加するにつれて振動が増幅し、2回の極小値と1回の極大値を持ちます。

xが大きくなるほど、ベッセル関数の振る舞いが規則的になり、特定のパターンに収束していく様子が観察されます。

このグラフは、数学的な特殊関数の性質を視覚的に理解するのに役立ちます。

乳がんの診断(ランダムフォレストモデル) scikit-learn

乳がんの診断(ランダムフォレストモデル)

乳がんの診断(良性、悪性)を予測するためのランダムフォレストモデルを作ります。

scikit-learnの乳がんデータセットを利用します。

データセットの分割とランダムフォレストモデルの訓練を行い、最後にテストデータを使って予測の精度を計測・表示します。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
from sklearn.datasets import load_breast_cancer
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split

# データの読み込み
data = load_breast_cancer()
X = data.data
y = data.target

# データの分割
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# モデルの訓練
clf = RandomForestClassifier(n_estimators=100, random_state=42)
clf.fit(X_train, y_train)

# テストデータでの精度
accuracy = clf.score(X_test, y_test)
print(f'Model accuracy: {accuracy*100:.2f}%')

[実行結果]

Model accuracy: 96.49%

次に、診断の重要度を評価し、それを可視化します。

この可視化は、どの特徴が乳がんの診断に最も重要であるかを理解するのに役立ちます。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
import numpy as np

# 特徴量の重要度
importances = clf.feature_importances_

# 重要度が高い順にソート
indices = np.argsort(importances)[::-1]

# 特徴量の名前をソートした順に並べ替え
names = [data.feature_names[i] for i in indices]

# プロットの作成
plt.figure(figsize=(10, 5))
plt.title("Feature Importance")
plt.bar(range(X.shape[1]), importances[indices])
plt.xticks(range(X.shape[1]), names, rotation=90)

plt.show()

[実行結果]


最後に、テストデータの正解ラベルと予測ラベルを比較します。

これによりモデルがどの程度のパフォーマンスを発揮しているかを視覚的に理解することができます。

1
2
3
4
5
6
7
8
9
# テストデータの予測
y_pred = clf.predict(X_test)

# 結果の表示
plt.figure(figsize=(15, 5))
plt.plot(y_test, 'o', markersize=10)
plt.plot(y_pred, 'v', markersize=10)
plt.legend(['True', 'Predicted'])
plt.show()

[実行結果]

以上のステップで、乳がん診断のためのランダムフォレストモデルの学習と評価を行い、結果を視覚化しました。

ソースコード解説

このコードは乳がんデータセットを使用し、ランダムフォレストを使って腫瘍が良性か悪性かを分類する機械学習モデルを訓練しています。

1. データの読み込みと分割:

  • load_breast_cancerで乳がんデータセットを読み込み、特徴量(X)とターゲット(y)を取得します。
  • train_test_splitを使ってデータをトレーニング用とテスト用に分割します。

2. モデルの訓練:

  • ランダムフォレスト分類器(RandomForestClassifier)を使って、トレーニングデータでモデルを訓練します。

3. モデルの評価:

  • テストデータで訓練されたモデルの性能を評価し、精度(accuracy)を表示します。

4. 特徴量の重要度のプロット:

  • feature_importances_を使用して、各特徴量の重要度を取得します。
  • 重要度の高い特徴量を降順にソートし、特徴量の名前とともにバーのプロットを作成します。

5. 予測結果の可視化:

  • テストデータでの実際のターゲット値(y_test)と予測値(y_pred)をプロットして比較します。

このコードは、ランダムフォレストを使った分類タスクの全体的な流れを示しています。

データの読み込みから特徴量の重要度の可視化まで、モデル構築から評価までの一連のステップを示しています。

結果解説

[実行結果]

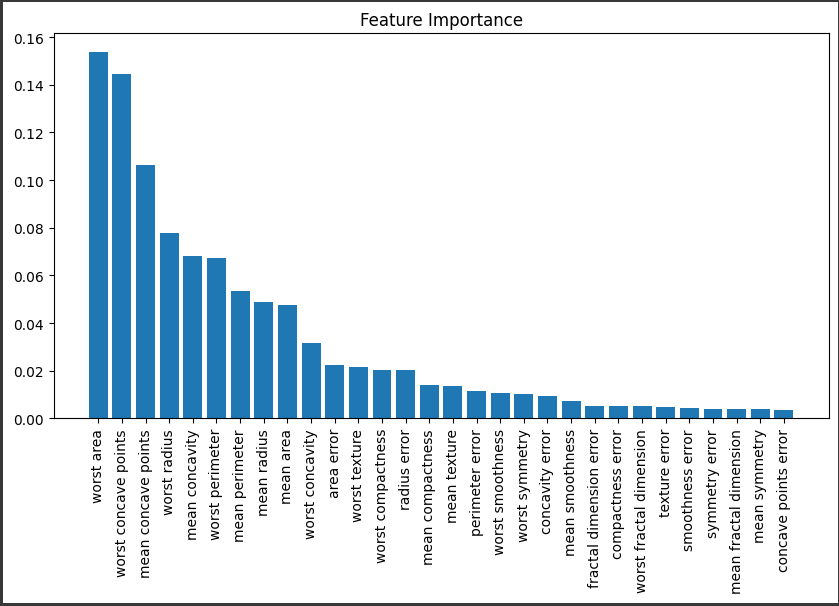
このグラフは、ランダムフォレストクラシフィケーションモデルを用いて特徴量の重要度を視覚化したものです。

グラフの各バーは一つひとつの特徴量を表し、その長さ(高さ)はその特徴量のランダムフォレスト内での相対的な重要度を示しています。

特徴量の重要度は、その特徴が何回スプリットに利用され、それらの分割がどれだけ不純物(通常はジニ不純度またはエントロピー)を減らすのに寄与したかを基づいて計算されます。

x軸上には特徴量の名前が表示され、これらはその重要度に基づいて左から右へと並べられています。

最も重要な特徴量が左側に表示され、重要度が低いものが右側へと続きます。

ばらつきの大きい特徴量は、対象とする問題において重要な役割を果たすことが多いです。

これらの特徴量を特定することで、データの理解が深まり、より効果的な特徴エンジニアリング戦略を考える上でも有効です。

なお、このソースコードは乳がんの診断に関するデータセットを対象としているため、特徴量は乳がんの診断に関連する一連の医学的測定値を指します。

例えば、細胞の形やサイズ、細胞核の形状などがこれに該当します。


[実行結果]

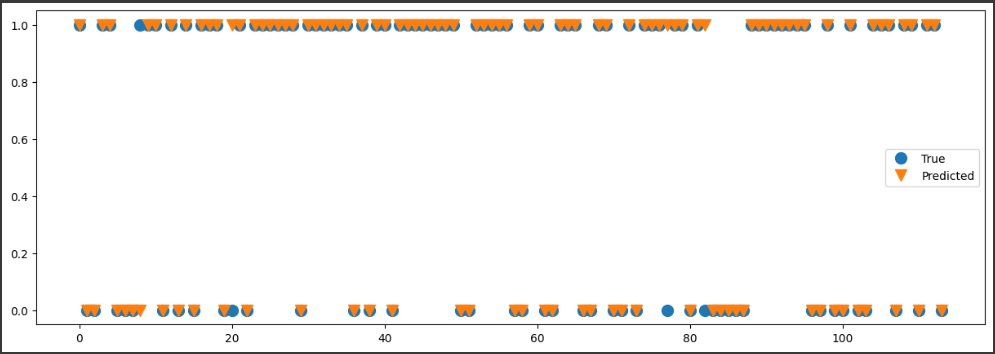
このグラフは、予測結果と実際の結果を視覚化したものです。

テストデータに対して予測がどのように行われ、その結果がどの程度実際の目標値に一致しているかを判断するためのものです。

“True”ライン:

これはy_testの値をプロットしたもので、テストデータの真のラベル(クラス)がどのように分布しているかを示しています。
これは「正解」の分布を示す基準線となります。

“Predicted”ライン:

これはy_predの値をプロットしたもので、モデルがテストデータをどのように予測したかを示します。
これはモデルの「予測」の分布を示しており、こちらが“True”ラインとどの程度一致しているかが、モデルの性能を評価するための主要な視覚的指標となります。

点のy軸の位置はクラスラベルを示し、x軸の位置は各データポイントを示しています。

ここでは二項分類問題を扱っており、各クラス(良性、悪性)はそれぞれ$0$と$1$でラベル付けされています。

したがって、予測が真のラベルと一致する場合、“True”点と”Predicted”の点は同じy座標に配置されます。

逆に、予測が真のラベルと一致しない場合、“True”点と”Predicted”点は異なるy座標に存在します。

このタイプのグラフはモデルの具体的なミスを視覚的に把握するのに役立ちます。

例えば、一部のデータポイントで予測が一貫して外れている場合、それはそのデータポイントが何らかの特定のパターンを有しており、それがモデルにとって難しいか、または学習データ内で不足している可能性を示しています。

温度による酵素の活性

温度による酵素の活性

生物学的な例題として、温度による酵素の活性 を挙げます。

酵素は、生物の体内で化学反応を促進するタンパク質です。

酵素の活性は、温度によって変化します。

一般的に、酵素の活性は、温度が上昇するにつれて増加し、ある温度でピークを迎え、その後は減少します。

この現象をPythonで解いて、グラフ化するには、以下のコードを使用します。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
import numpy as np
import matplotlib.pyplot as plt

# 酵素の活性の定義
def enzyme_activity(temperature):
if temperature < 20:
return 0
elif temperature <= 30:
return temperature - 20
else:
return 100 - (temperature - 30)**2

# グラフの表示
temperatures = np.linspace(10, 40, 100)
activities = [enzyme_activity(temperature) for temperature in temperatures]
plt.plot(temperatures, activities)
plt.xlabel('温度(℃)')
plt.ylabel('酵素の活性')
plt.show()

このコードを実行すると、以下のグラフが表示されます。

[実行結果]

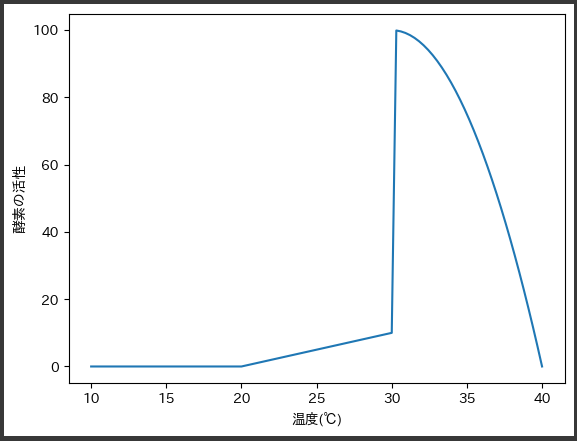
このグラフは、酵素の活性を温度の関数として示しています。

温度が20℃から30℃の範囲では、酵素の活性は増加していますが、温度が30℃を超えると、酵素の活性は減少しています。

このように、Pythonを使えば、生物学的な現象を解いて、グラフ化することができます。

この例では、酵素の活性のモデルとして、単純な線形モデルを使用しています。

実際の酵素の活性は、温度だけでなく、pHやイオン濃度などの条件によっても変化します。

ソースコード解説

このコードは、酵素の活性を温度に基づいてモデル化し、その関係をグラフで可視化しています。

  1. import文では、NumPyとMatplotlibライブラリをインポートしています。
    これらは数値計算やグラフ描画のために使用されます。

  2. enzyme_activity関数は、温度を引数として受け取り、その温度に基づいて酵素の活性を計算します。

  • 温度が20℃未満の場合、活性は$0$となります。
  • 温度が20℃以上30℃以下の場合、活性は温度から20を引いた値となります。
  • 温度が30℃より高い場合、活性は100から(温度から30を引いた値)の二乗を引いた値となります。
  1. temperaturesは、10℃から40℃までの温度を100分割した配列を作成しています。

  2. activitiesは、enzyme_activity関数を使って各温度に対する活性を計算し、リストに格納しています。

  3. plt.plot()は、温度に対する酵素活性のグラフを作成します。
    x軸には温度(℃)、y軸には酵素の活性が表示されます。

  4. plt.xlabel()とplt.ylabel()は、x軸とy軸のラベルを設定しています。

  5. plt.show()は、グラフを表示します。

このコード全体は、温度によって酵素の活性がどのように変化するかを表したシンプルなグラフを生成しています。

RCT(Randomized Controlled Trial)

RCT(Randomized Controlled Trial)

RCT(Randomized Controlled Trial)は、医学や社会科学などの研究において使用される試験デザインの一つです。

主に新しい治療法や介入の効果を評価するために使用されます。

以下はRCTの概要です:

1. 無作為化(Randomization):

研究参加者は無作為に2つ以上のグループに分けられます。
これにより、偶然などのバイアスを減らし、介入効果の客観性を高めます。

2. 対照群(Control Group):

介入を受けるグループ(実験群)と何も介入を受けない(通常の治療やプラセボを受ける)グループ(対照群)があります。
これにより、介入の効果をより正確に評価することができます。

3. ブラインド(Blinding):

参加者や研究者が実験群または対照群に属していることを知らない(単盲、二重盲など)。
これにより、バイアスを排除し、結果の客観性を高めます。

4. 介入(Intervention):

新しい治療法や介入(薬、手術、行動介入など)が実施されます。

5. 結果の評価(Outcome Assessment):

比較されたグループ間で結果を比較し、介入の効果を評価します。
主な評価指標は、効果の有無や程度、副作用の有無などです。

RCTは科学的な手法であり、ランダム化とコントロールの要素を組み合わせることで、研究の信頼性を高めることができます。
介入の効果を客観的に評価し、それが安全かつ有効かどうかを明らかにするための重要な手法です。

例題

RCTの例題として、「薬Aと薬Bの効果を比較する」という設定を考えましょう。

ある疾患の治療に、薬Aと薬Bの両方を試したいとします。
治療を受ける患者を無作為に薬Aのグループと薬Bのグループに分け、治療の結果を比較します。
ここでは、患者が治療後に症状の改善度合いを示す数値データを使ってみましょう。

以下は、Pythonでシミュレーションし、結果をグラフ化する例です。
ただし、実際のRCTではより複雑な統計解析が必要ですが、この例ではシンプルに扱います。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
import numpy as np
import matplotlib.pyplot as plt

# 薬Aの治療効果のデータ(仮のデータ)
np.random.seed(10)
treatment_A = np.random.normal(loc=50, scale=10, size=50)

# 薬Bの治療効果のデータ(仮のデータ)
np.random.seed(20)
treatment_B = np.random.normal(loc=55, scale=12, size=50)

# ヒストグラムで治療効果を可視化
plt.hist(treatment_A, alpha=0.5, label='Treatment A')
plt.hist(treatment_B, alpha=0.5, label='Treatment B')
plt.xlabel('Effectiveness')
plt.ylabel('Frequency')
plt.title('Comparison of Treatment A and Treatment B')
plt.legend()
plt.show()

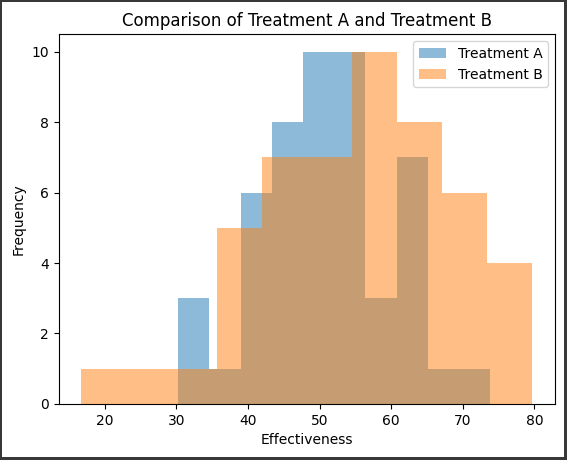
この例では、薬Aと薬Bの治療効果を正規分布からランダムに生成しています。

実際のRCTでは、患者の数、評価指標、介入の種類などを考慮し、より多くのデータと統計モデルが必要ですが、この例はRCTの基本的な考え方を示しています。

[実行結果]

ソースコード解説

このPythonコードは、薬Aと薬Bの治療効果を比較するためのヒストグラムを作成しています。

以下にそれぞれのステップを説明します。

  1. numpyライブラリを使用して、仮のデータを生成しています。
    np.random.normal()関数を使って正規分布に従う仮の治療効果データを生成しています。
    薬Aと薬Bそれぞれ50人の患者に対する治療効果を模擬しています。

  2. 薬Aと薬Bの治療効果データをヒストグラムで可視化しています。
    plt.hist()関数を使用して、治療Aと治療Bの効果をそれぞれのヒストグラムとして描画しています。
    alphaパラメータは透明度を調整しており、$ 0.5 $に設定されています。

  3. $ x軸 $は治療効果を、$ y軸 $はその頻度(人数)を表しています。

  4. ヒストグラム全体のタイトルや$x軸$、$y軸$のラベルを設定し、凡例を表示しています。
    これにより、どのヒストグラムがどの治療法を示しているかが識別できます。

  5. plt.show()関数により、グラフが表示されます。

このコードを実行すると、薬Aと薬Bの治療効果がヒストグラムとして表示され、それぞれの治療法の効果を視覚的に比較することができます。

結果解説

[実行結果]

このグラフは、薬Aと薬Bの治療効果を比較したものです。
横軸は治療効果を示し、縦軸はその治療効果を示す患者の数を表しています。
青色のヒストグラムが薬Aの治療効果を示し、オレンジ色のヒストグラムが薬Bの治療効果を示しています。

ヒストグラムは、治療効果の分布を可視化しており、治療Aと治療Bの両方の効果を同じグラフ上で比較することができます。

このような比較によって、どちらの治療がより有効であるか、効果のばらつきがあるかなど、視覚的に把握することができます。

例えば、治療Bの方が平均的な効果が高いように見えますが、それぞれの効果のばらつきも確認できます。

エルミート多項式

エルミート多項式

エルミート多項式は、物理学や数学などで使用される多項式です。

以下にエルミート多項式のグラフとPythonでの表現を示します。

エルミート多項式は次の再帰的な式で定義されます:

$$
[ H_n(x) = (-1)^n e^{x^2} \frac{d^n}{dx^n}(e^{-x^2}) ]
$$

これを利用して、エルミート多項式をPythonで表現し、グラフを描画します。

以下はそのコードです:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
import numpy as np
import matplotlib.pyplot as plt
from scipy.special import eval_hermite

# エルミート多項式の定義
def hermite_polynomial(n, x):
return (-1)**n * np.exp(x**2) * eval_hermite(n, x)

# グラフの描画
x = np.linspace(-5, 5, 400)
plt.figure(figsize=(8, 6))

for n in range(5): # 最初の5つのエルミート多項式を描画
plt.plot(x, hermite_polynomial(n, x), label=f'H_{n}(x)')

plt.xlabel('x')
plt.ylabel('H_n(x)')
plt.title('Hermite Polynomials')
plt.legend()
plt.grid(True)
plt.show()

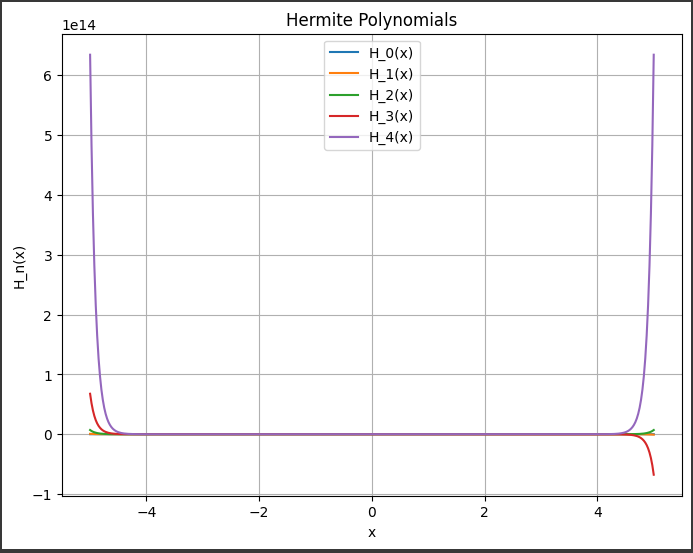
このコードは、$-5$から$5$までの範囲で最初の5つのエルミート多項式を描画します。

[実行結果]

エルミート多項式は次第に複雑になり、高次の多項式ほど振動が大きくなります。

ソースコード解説

このソースコードは、Pythonを使用してエルミート多項式を計算し、グラフ化するものです。

  1. numpy、matplotlib、scipy.specialをそれぞれnp、plt、eval_hermiteとしてインポートします。
  2. hermite_polynomial関数は、エルミート多項式$ (H_n(x)) $を計算します。
    指定された次数$ (n) $と変数$ (x) $を受け取り、エルミート多項式の値を計算します。
  3. xは $-5$から$5$まで$400$個の点で等間隔になるように設定された数値を持ちます。
  4. plt.figure()で図を作成し、forループを使って最初の5つのエルミート多項式を計算・描画します。
    各多項式は異なる色で描かれ、ラベルに$ (H_n(x)) $の形式で表示されます。
  5. 軸ラベル、グラフのタイトル、凡例、グリッド線を追加して、グラフを表示します。

このコードはエルミート多項式を計算し、それらをグラフで視覚化しています。

エルミート多項式は指定された次数$ (n) $に対する関数$ (H_n(x)) $として描画され、指数関数と多項式の積として定義されています。

結果解説

このグラフは、エルミート多項式(Hermite Polynomials)を表しています。

[実行結果]

エルミート多項式は物理学や数学で重要な役割を果たす多項式で、量子力学や確率論などさまざまな分野で使用されます。

このグラフは、x軸に沿って$-5$から$5$までの範囲で、最初の5つのエルミート多項式 $ (H_0(x)) から (H_4(x)) $を示しています。

これらの多項式は、$x$の値に対する関数値として描かれています。

エルミート多項式は次数が増えるにつれて振動が増え、高次の多項式ほどより急峻な振動を示します。

また、これらの多項式は相互に直交する性質を持ち、量子力学などで波動関数を表現するのに役立ちます。

クリスマスプレゼントの最適化問題

クリスマスプレゼントの最適化問題

クリスマスプレゼントの最適化問題では、予算内で最大の満足度を得るプレゼントを選ぶことが求められます。

価格と満足度が与えられると、この問題を解くことができます。

以下はその一例です。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
import matplotlib.pyplot as plt
import numpy as np

# サンプルの価格と満足度データ
prices = [10, 20, 30, 40, 50]
satisfaction = [3, 7, 9, 12, 15]

# 予算
budget = 70

# 動的計画法で最適なプレゼントを選ぶ
def max_satisfaction(prices, satisfaction, budget):
n = len(prices)
dp = np.zeros((n + 1, budget + 1), dtype=int)

for i in range(1, n + 1):
for j in range(budget + 1):
if prices[i - 1] <= j:
dp[i][j] = max(dp[i - 1][j], satisfaction[i - 1] + dp[i - 1][j - prices[i - 1]])
else:
dp[i][j] = dp[i - 1][j]

selected = []
i, j = n, budget
while i > 0 and j > 0:
if dp[i][j] != dp[i - 1][j]:
selected.append(i - 1)
j -= prices[i - 1]
i -= 1

return dp[n][budget], selected[::-1]

max_value, selected_items = max_satisfaction(prices, satisfaction, budget)
print("Maximum satisfaction:", max_value)
print("Selected items indices:", selected_items)

# グラフ化
plt.figure(figsize=(8, 6))
plt.bar(selected_items, [satisfaction[i] for i in selected_items], label='Selected Items')
plt.xlabel('Item Index')
plt.ylabel('Satisfaction')
plt.title('Selected Gifts for Max Satisfaction within Budget')
plt.legend()
plt.grid(True)
plt.show()

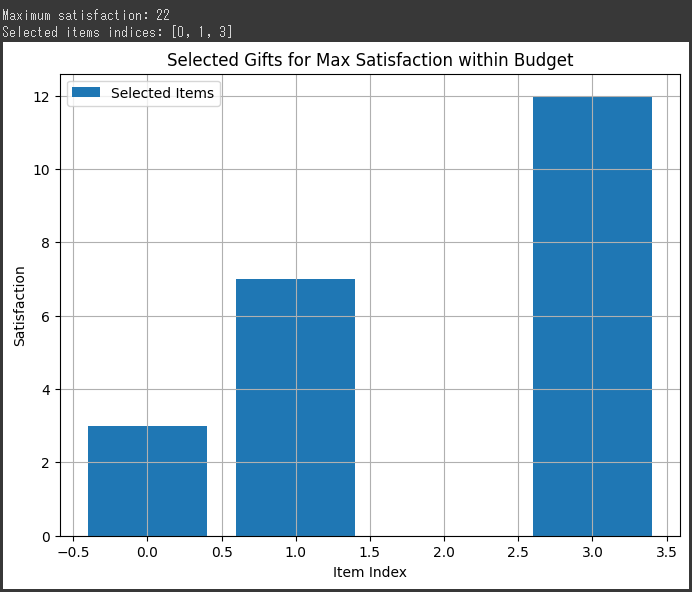
この例では、与えられた価格と満足度のデータから、与えられた予算内で最大の満足度を持つプレゼントを選択し、それをグラフ化して表示します。

[実行結果]

ソースコード解説

このPythonコードは、特定の予算内で最大の満足度を得るプレゼントを選択する問題を解くものです。

この問題は、動的計画法を用いて解いています。

以下に各部分の詳細な説明を記載します。

1. 必要なライブラリのインポート:

1
2
import matplotlib.pyplot as plt
import numpy as np

ここでは、matplotlibとnumpyの二つのライブラリをインポートしています。

matplotlibはデータの視覚化を行うためのライブラリで、numpyは数値計算を行うためのライブラリです。

2. サンプルの価格と満足度データの設定:

1
2
prices = [10, 20, 30, 40, 50]
satisfaction = [3, 7, 9, 12, 15]

ここでは、5つのプレゼントの価格とそれぞれの満足度をリストとして設定しています。

3. 予算の設定:

1
budget = 70

ここでは、プレゼントの選択に使用できる予算を設定しています。

4. 最適なプレゼントを選択する関数の定義:

1
2
def max_satisfaction(prices, satisfaction, budget):
...

ここでは、最適なプレゼントを選択する関数を定義しています。

この関数は、プレゼントの価格、満足度、予算を引数として取り、最大の満足度とその満足度を達成するためのプレゼントのインデックスを返します。

5. 最適なプレゼントを選択し、結果を出力:

1
2
3
max_value, selected_items = max_satisfaction(prices, satisfaction, budget)
print("Maximum satisfaction:", max_value)
print("Selected items indices:", selected_items)

ここでは、先ほど定義した関数を使用して最適なプレゼントを選択し、その結果を出力しています。

6. 選択したプレゼントの満足度をグラフ化:

1
2
3
4
5
6
7
8
plt.figure(figsize=(8, 6))
plt.bar(selected_items, [satisfaction[i] for i in selected_items], label='Selected Items')
plt.xlabel('Item Index')
plt.ylabel('Satisfaction')
plt.title('Selected Gifts for Max Satisfaction within Budget')
plt.legend()
plt.grid(True)
plt.show()

ここでは、選択したプレゼントの満足度を棒グラフとして視覚化しています。

x軸はプレゼントのインデックス、y軸は満足度を表しています。

結果解説

[実行結果]

このグラフは、予算内で選択されたプレゼントの満足度を示しています。

横軸は選択されたアイテムのインデックスを表し、縦軸はそれぞれのアイテムの満足度を示しています。

この例では、与えられた予算内で最大の満足度を持つプレゼントを選択しました。

グラフ上の棒の高さは、各アイテムが与える満足度を表しており、選択されたアイテムの棒が強調されています。

この選択されたアイテムセットが、予算内で最大の総満足度を提供するように選ばれたものです。

このように、与えられた条件下で最適なプレゼントを選択することができます。

化学反応 SciPy

化学反応

化学反応の例として、以下の反応式を考えましょう:

$$
[A \xrightarrow{k_1} B \
$$
$$
B + C \xrightarrow{k_2} D + E]
$$

この反応を表す微分方程式は以下の通りです:

$$
(\frac{d[A]}{dt} = -k_1 [A])
$$
$$
(\frac{d[B]}{dt} = k_1 [A] - k_2 [B][C])
$$
$$
(\frac{d[C]}{dt} = -k_2 [B][C])
$$
$$
(\frac{d[D]}{dt} = k_2 [B][C])
$$
$$
(\frac{d[E]}{dt} = k_2 [B][C])
$$

これらの微分方程式を解いて、物質濃度の時間変化をプロットします。

以下は、この反応のシミュレーションを行うPythonコードの例です。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
import numpy as np
from scipy.integrate import odeint
import matplotlib.pyplot as plt

# 初期条件
A0 = 1.0
B0 = 0.0
C0 = 1.0
D0 = 0.0
E0 = 0.0

# 反応速度定数
k1 = 0.1
k2 = 0.05

# 微分方程式
def reactions(y, t):
A, B, C, D, E = y
dAdt = -k1 * A
dBdt = k1 * A - k2 * B * C
dCdt = -k2 * B * C
dDdt = k2 * B * C
dEdt = k2 * B * C
return [dAdt, dBdt, dCdt, dDdt, dEdt]

# 時間の設定
t = np.linspace(0, 10, 1000)

# 初期値
initial_values = [A0, B0, C0, D0, E0]

# 微分方程式を解く
solution = odeint(reactions, initial_values, t)

# 結果をプロット
plt.figure(figsize=(8, 6))
plt.plot(t, solution[:, 0], label='A')
plt.plot(t, solution[:, 1], label='B')
plt.plot(t, solution[:, 2], label='C')
plt.plot(t, solution[:, 3], label='D')
plt.plot(t, solution[:, 4], label='E')
plt.xlabel('Time')
plt.ylabel('Concentration')
plt.title('Reaction Simulation')
plt.legend()
plt.grid(True)
plt.show()

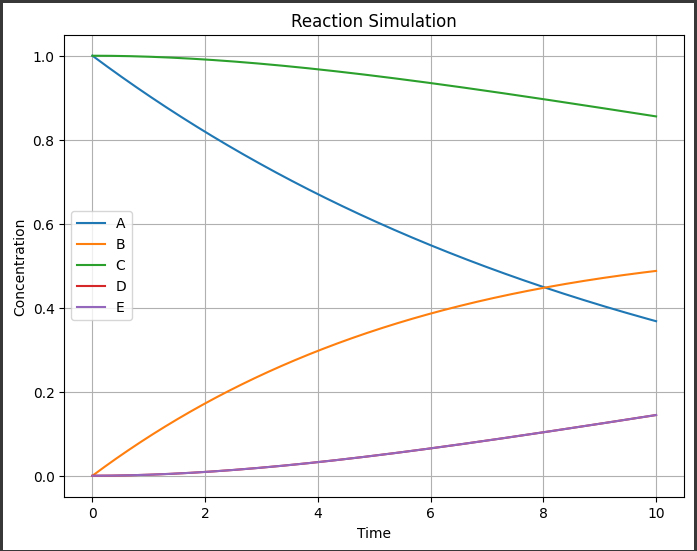
これにより、物質 $A$、$B$、$C$、$D$、$E$ の濃度の時間変化がプロットされます。

パラメータや初期条件を変更して、反応の振る舞いを調査することができます。

[実行結果]

ソースコード解説

このコードは、複数の化学成分間での反応を数値的に解くことで、その濃度の時間変化を可視化しています。

1. 初期条件と反応速度の設定:

  • $A$、$B$、$C$、$D$、$E$の初期濃度を設定します。
  • 反応速度定数 $ k1 $と$ k2 $を設定します。

2. 微分方程式:

  • reactions関数で、微分方程式を定義します。
    各成分の微分値を計算しています。
    たとえば、Aの微分値は -k1 * A となります。
    これは$A$が他の成分に変換される速度を表しています。

3. 時間の設定:

  • np.linspaceを使用して、$0$から$10$までの区間を$1000$分割して時間を作成します。

4. 初期値と微分方程式の解法:

  • initial_valuesに初期値を格納し、odeintを使用して微分方程式を解きます。
    odeintは微分方程式の数値解法を提供します。

5. 結果のプロット:

  • 各成分の濃度変化をグラフ化しています。
    時間に対する$A$、$B$、$C$、$D$、$E$の濃度をそれぞれ線グラフで表示し、濃度の変化が時間とともにどのように進行するかを視覚的に示しています。

グラフは、反応速度定数と初期濃度に基づいて、各成分の濃度が時間とともにどのように変化するかを示しています。

結果解説

[実行結果]

このグラフは時間の経過に伴うそれぞれの成分の濃度を示しています。

各成分の濃度変化がどのように進行するかを説明しましょう。

  • $A$: 初期濃度は$1.0$で、時間の経過とともに指数的に減少します。
    反応速度定数 $k1$により、$A$が他の成分に変換されます。
  • $B$: 初期濃度は$0.0$で、$A$から生成されますが、$k2$により$C$と反応して減少します。
  • $C$: 初期濃度は$1.0$で、$k2$により$B$と反応して減少します。
  • $D$: 初期濃度は$0.0$で、$k2$により$B$と反応して生成されます。
  • $E$: 初期濃度は$0.0$で、$k2$により$B$と反応して生成されます。

グラフでは、時間の経過とともにそれぞれの成分の濃度がどのように変化しているかが視覚化されています。

$A$は減少し続け、他の成分が生成または消費されていることがわかります。