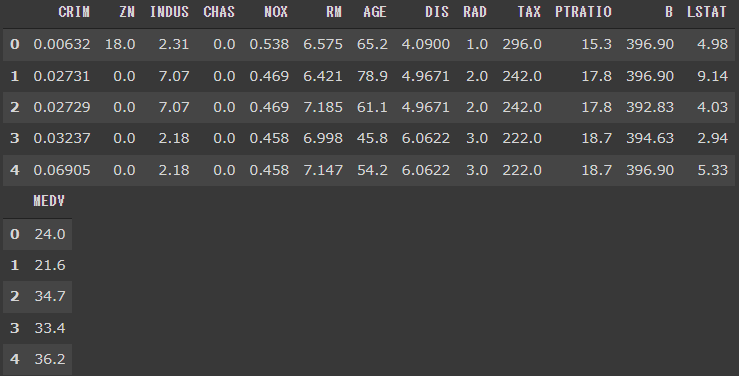
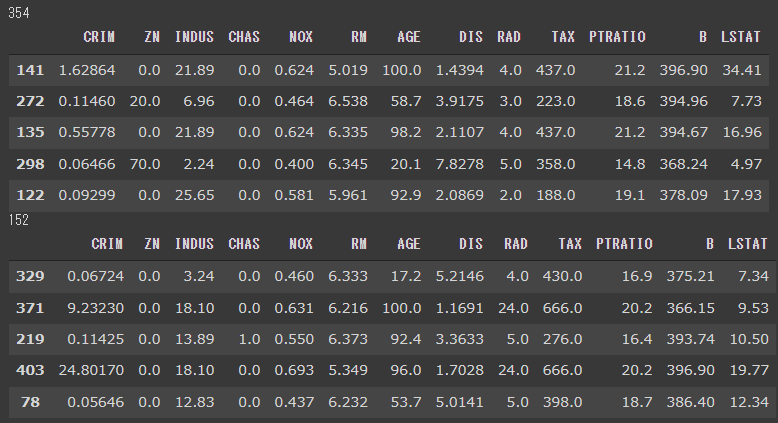
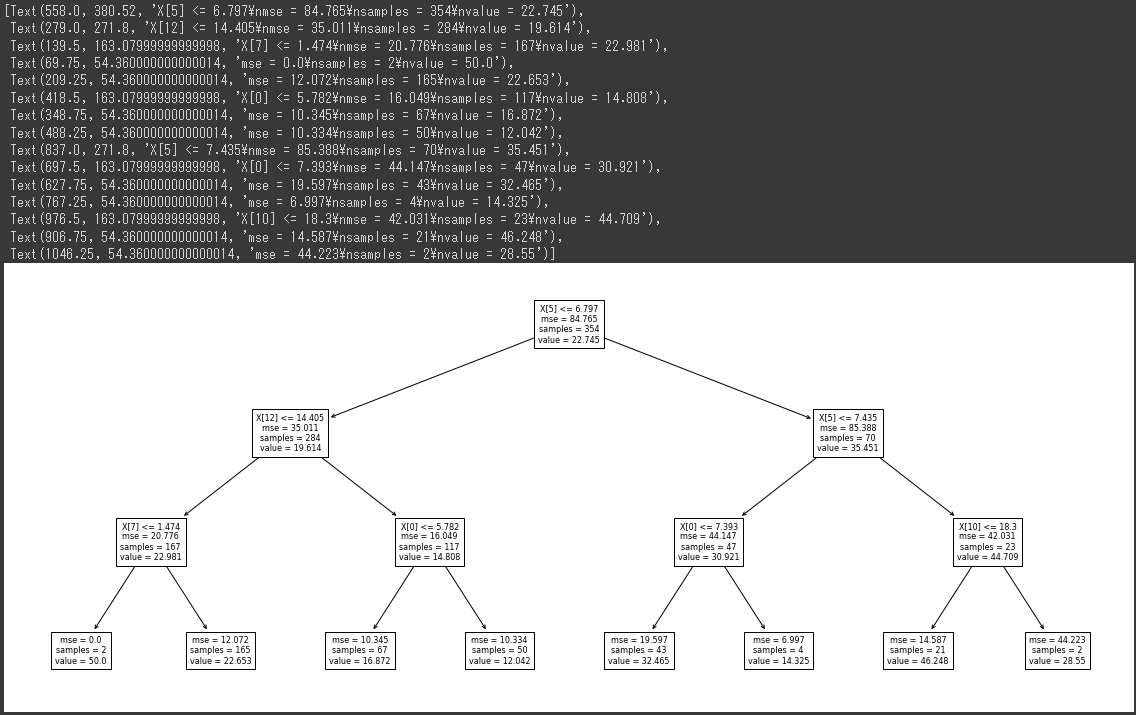
交差検証法とは、テストデータと訓練データを入れ替えて複数回学習・評価を行い、それぞれのスコアの平均値をとって最終的なモデルの評価を決定する手法です。
(一方、データセットをあらかじめ訓練データとテストデータに分割する手法はホールドアウト法と呼ばれます。)
今回は交差検証法の手法の中でも、最もメジャーなK分割交差検証法を行ってみます。
K分割交差検証法
交差検証での分割方法を定義するために、scikit-learnのKFoldクラスを使用します。
KFoldのn_splitでデータの分割数を指定しています。(5行目)
またshuffleをTrueに指定すると、分割を行う前にデータセット内のデータ順序をシャッフルすることができます。
[Google Colaboratory]
1
2
3
4
5
6
| from sklearn.model_selection import cross_val_score
from sklearn.model_selection import KFold
rf_cv = RandomForestRegressor(n_estimators=3, max_depth=5, random_state=0)
k_fold = KFold(n_splits=5, shuffle=True, random_state=0)
rf_scores = cross_val_score(estimator=rf_cv, X=X, y=y, cv=k_fold, scoring="r2")
|
cross_val_scoreが交差検証を行う関数です。(6行目)
パラメータの意味は次の通りです。
- estimator
交差検証で使用するモデル
- X
fitするデータ(説明変数)
- y
fitするデータ(目的変数)
- cv
交差検証でのデータセットの分割方法
- scoring
評価手法
[実行結果]
精度評価スコア
精度評価スコアを確認します。
cross_val_scoreは、交差検証で得られたスコアを返します。
[Google Colaboratory]
1
2
| print(f"各分割のスコア:{rf_scores}")
print(f"平均スコア:{np.mean(rf_scores)}")
|
[実行結果]

平均スコアは0.77となりました。
今回の交差検証では5回検証を行いましたが、各分割でのスコアの幅は0.66~0.86と広くなっています。
ホールドアウト法による1回の分割だけで、モデルを評価するのは不十分であることがよくわかります。