Prioritized Experience Replayという深層強化学習を実装します。
- Prioritized Experience Replayは、学習がきちんと進んでいない状態に対して優先的に学習させる深層強化学習です。
- 具体的には誤差が大きいtransitionを優先的にExperience Replay時に学習させ、価値関数のニューラルネットワークの出力誤差が小さくなるようにします。
使用するパッケージをインポートします。
1 | # パッケージのimport |
動画ファイルを保存する関数を定義します。
1 | # 動画の描画関数の宣言 |
経験(Transition)を表すnamedtupleを生成します。
(状態 state、行動 action、次の状態 next_state、報酬 rewardに容易にアクセスできます。)
1 | # namedtupleを生成 |
定数を宣言します。
1 | # 定数の設定 |
経験を保存するメモリクラスを定義します。
- 経験を保存する関数 push、ランダムに経験を取り出す関数 sampleがあります。
1 | # 経験を保存するメモリクラスを定義します |
TD誤差を格納するメモリクラスを定義します。
- 関数 get_prioritized_indexes はメモリ格納されている誤差の大きさに応じて確率的にindexを求める関数です。
- 関数 update_td_erro はメモリに格納されている誤差を更新するための関数です。
1 | # TD誤差を格納するメモリクラスを定義します |
ニューラルネットワークを構築するクラスを定義します。
1 | # ディープ・ニューラルネットワークの構築 |
Brainクラスを実装します。
(このクラスがニューラルネットワークを保持します。)
初期化関数にはTD誤差を格納するクラス TDerrorMemory のオブジェクト生成処理を追加します。
- 関数 replay では最初にExperience Replay を行い、途中から Prioritized Experience Replayに切り替えます。
- 関数 update_td_error_memory でメモリオブジェクトの保存された全transitionのTD誤差を再計算します。
1 | # エージェントが持つ脳となるクラスです、PrioritizedExperienceReplayを実行します |
棒付き台車を表すAgentクラスを実装します。
- 関数 memorize でメモリオブジェクトに経験したデータ transition を格納します。
- 関数 memorize_td_erro ではそのステップでのTD誤差を格納します。
- 関数 update_td_error_memory は各試行の終わりに実行され TDerrorMemory クラスのオブジェクトに格納されたTD誤差を更新します。
1 | # CartPoleで動くエージェントクラスです、棒付き台車そのものになります |
CartPoleを実行する環境クラスを定義します。
(表形式表現のように離散化は行わず、観測結果 observationをそのままstateとして使用します。)
- 各ステップでのTD誤差をTD誤差メモリに追加します。
- Q_Networkの更新には引数 episode を追加します。(update_q_function関数)
- 各試行の終わりにはTD誤差メモリの中身を更新させます。
1 | # CartPoleを実行する環境のクラスです |
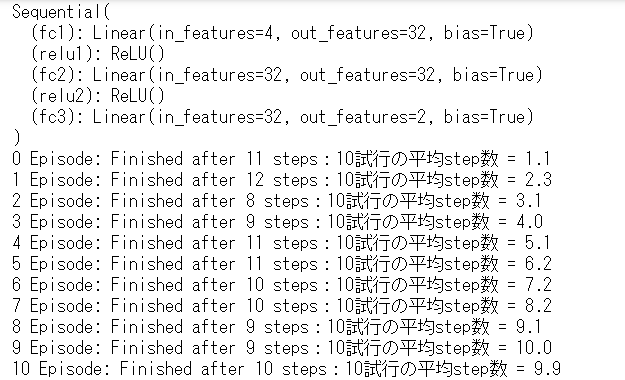
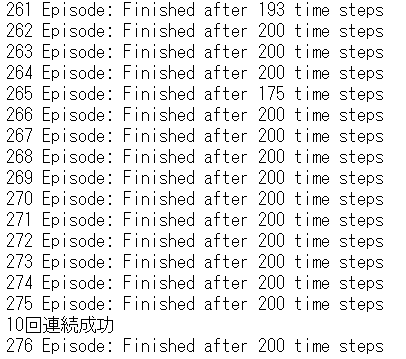
学習を実行します。
1 | # main クラス |
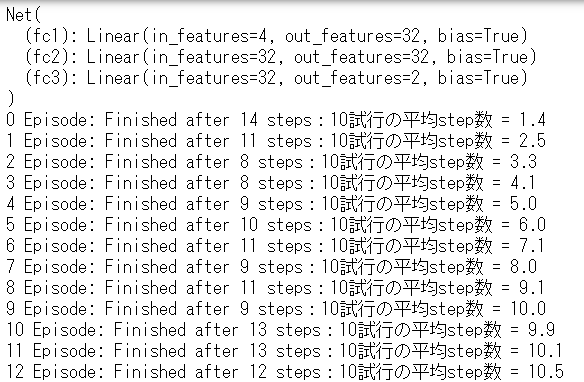
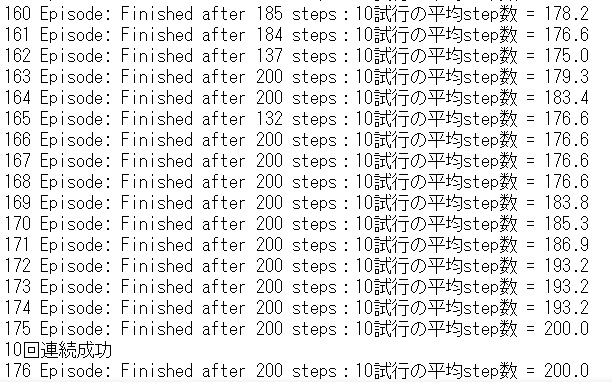
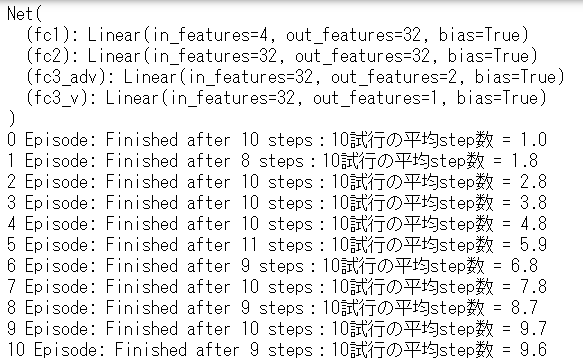
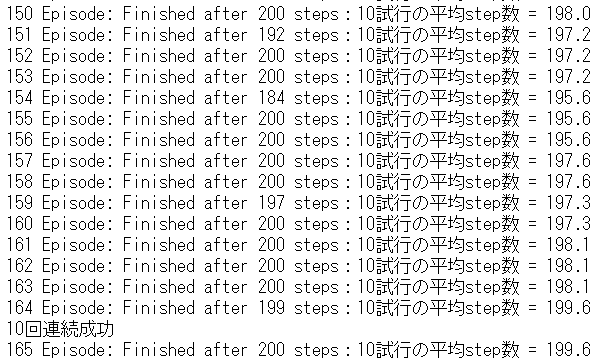
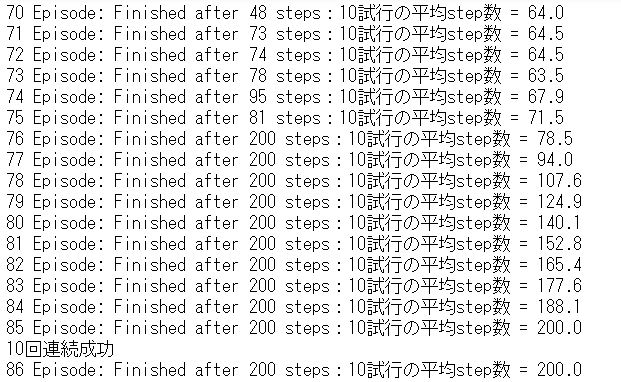
175エピソードで学習が完了しました。
出力された動画ファイル’6_4movie_cartpole_prioritized_experience_replay.mp4’は下記のようになります。
参考 > つくりながら学ぶ!深層強化学習 サポートページ