Dash + Dask
Daskは、メモリにのらないような大きなデータを扱う際によく使われるライブラリです。
主な特徴は、以下の通りです。
- 並列処理・分散処理などを簡単に扱える。
- Pythonでよく使われるライブラリ(NumPy、Pandas、Scikit-Learnなど)とかなり近いインターフェイスを提供している。
- データを全てメモリに乗せず、ある単位でメモリに乗せたりして計算するので、通常Pandasなどでメモリに乗り切らない大きなデータセットでも扱える。
サンプル
DashでDaskを使った簡単なサンプルを作成します。
下記のファイルをダウンロードして、ソースコードと同じ位置に配置しておきます。
CSVデータ - https://gist.githubusercontent.com/chriddyp/5d1ea79569ed194d432e56108a04d188/raw/a9f9e8076b837d541398e999dcbac2b2826a81f8/gdp-life-exp-2007.csv
[ソースコード]
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
| import dash
from dash import dcc, html
import plotly.express as px
import dask.dataframe as dd
app = dash.Dash(__name__)
df = dd.read_csv('./gdp-life-exp-2007.csv')
def filter_df(pop_thresh):
filt_df = df[df["population"] > pop_thresh].compute()
return filt_df
def build_graphs():
pop_thresh = 5 * 10 ** 6
filt_df = filter_df(pop_thresh)
fig_out = px.scatter(filt_df, x="gdp per capita", y="life expectancy",
size="population", color="continent", hover_name="country",
log_x=True, size_max=60)
return fig_out
fig = build_graphs()
app.layout = html.Div([
dcc.Graph(
id='life-exp-vs-gdp',
figure=fig
)
])
if __name__ == '__main__':
app.run_server(debug=True)
|
読み込んだ元のデータフレーム(df) をフィルタリングして、filt_df を作成しています。(filter_df関数)
元のデータ(df) は Dask DataFrammeでしたが、compute()メソッドで Pandas DataFrame に変換されています。(11行目)
この処理により、よりコンパクトなメモリ内オブジェクト(filt_df)を利用して図を作成することができます。
Dashを使うことにより計算コストの高い繰り返しを最小限に抑えることができます。
[ブラウザで表示]
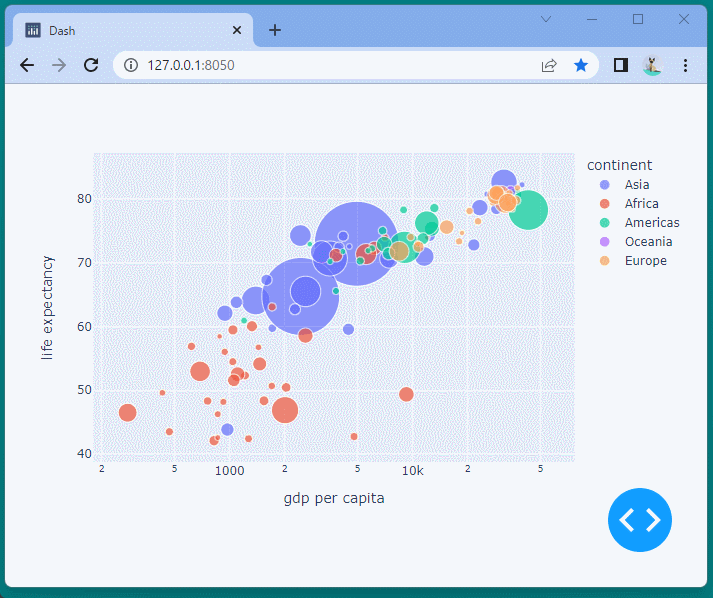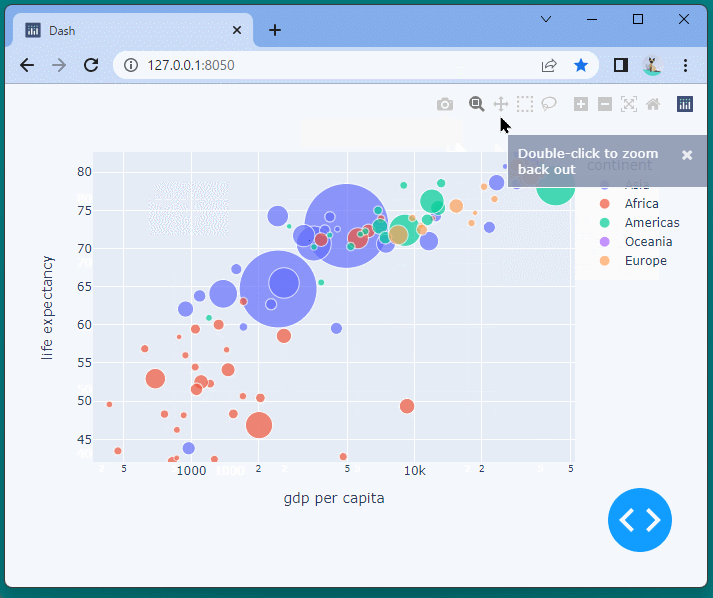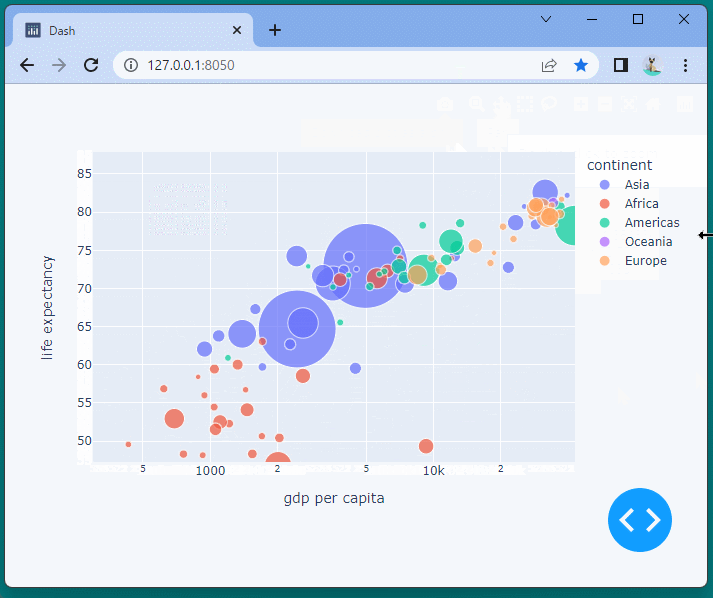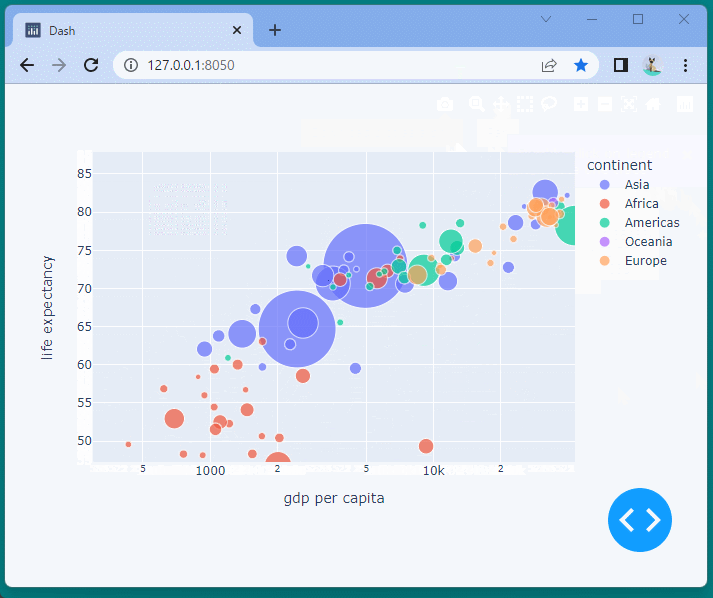
平均寿命とGDPを表したバブルチャートを表示することができました。
指定した範囲を拡大表示したり、移動したり、凡例をクリックしデータの表示と非表示を切り替えたりすることが可能です。